Наталя ХандусенкоШІ
11 вересня 2026, 12:42
2026-09-11
DeepSeek випустила мультимодальну модель V4.1-Flash із меншим споживанням пам'яті та рекордною швидкістю
Китайська ШІ-компанія DeepSeek презентувала нову модель DeepSeek-V4.1-Flash. Новинка побудована на архітектурі Mixture-of-Experts (MoE) загальним обсягом 552 млрд параметрів та має нативну підтримку аналізу візуальних даних. За заявою розробників, V4.1-Flash є найменшою у новій лінійці архітектур, проте перевершує за продуктивністю та економічністю попередні флагмани.
Китайська ШІ-компанія DeepSeek презентувала нову модель DeepSeek-V4.1-Flash. Новинка побудована на архітектурі Mixture-of-Experts (MoE) загальним обсягом 552 млрд параметрів та має нативну підтримку аналізу візуальних даних. За заявою розробників, V4.1-Flash є найменшою у новій лінійці архітектур, проте перевершує за продуктивністю та економічністю попередні флагмани.
Архітектура та технічні особливості
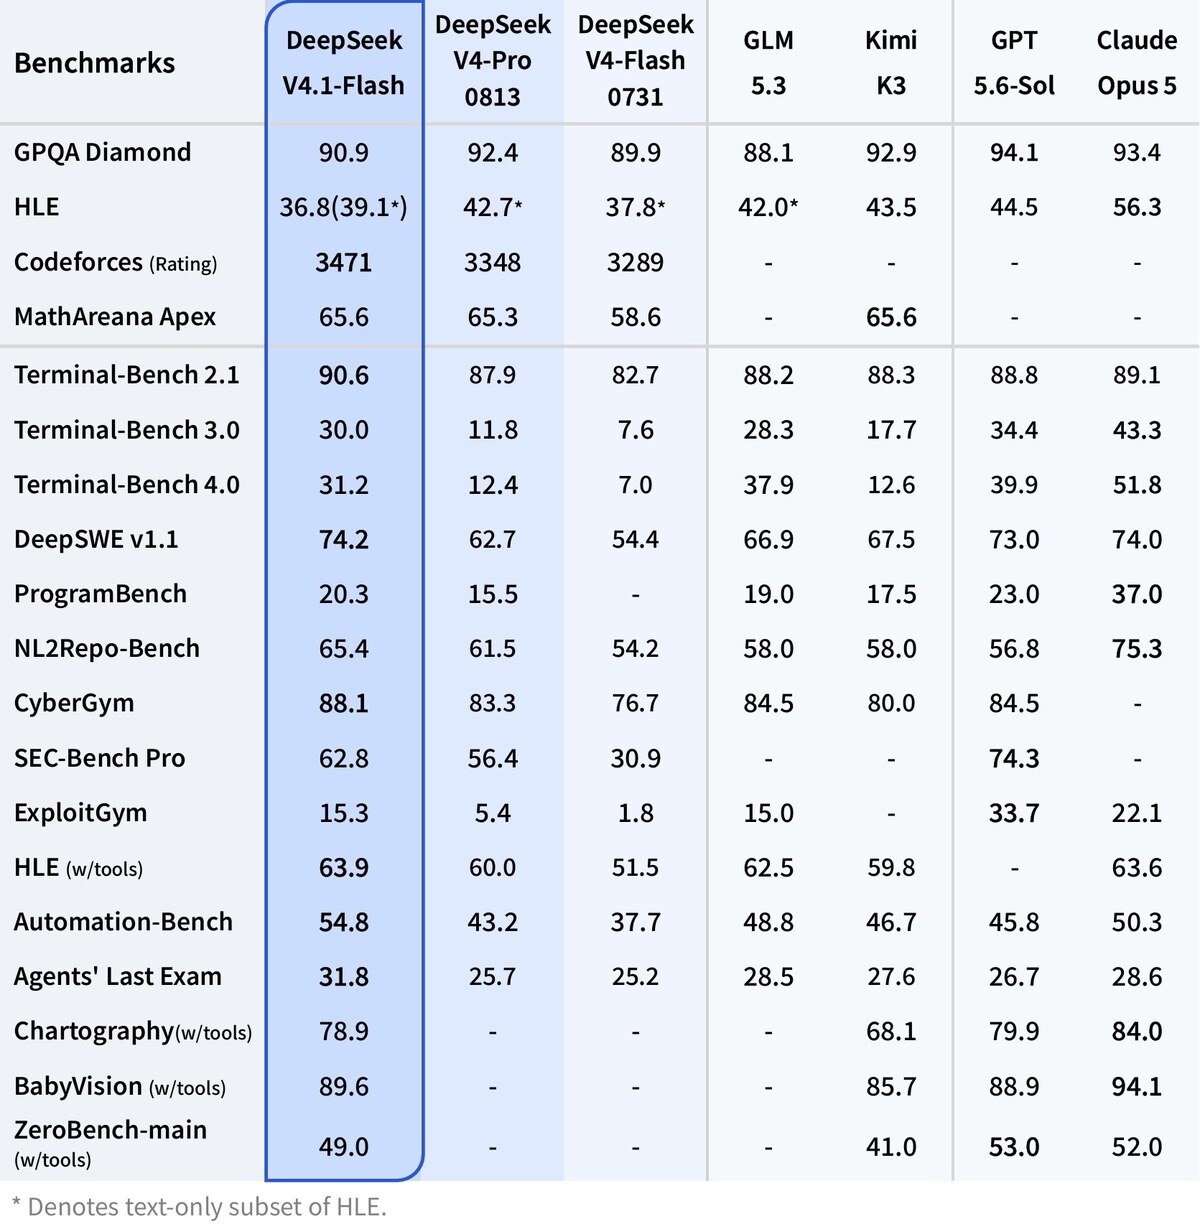
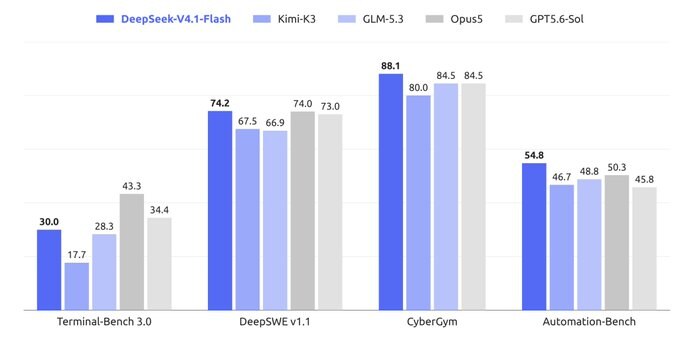
Завдяки використанню нової архітектури Causal Encoder-Decoder модель використовує лише 8 млрд активних параметрів для вводу та 16 млрд для виводу, повідомляє Neowin. Завдяки новим методам попереднього навчання та масштабному навчанню з підкріпленням (RL), V4.1-Flash показала результати у бенчмарках, що перевищують показники таких моделей, як Kimi-K3, GLM-5.3, Claude Opus 5, GPT 5.6-Sol та власної попередниці DeepSeek-V4-Pro.
Розробники також суттєво зменшили навантаження на апаратні ресурси. Моделі потрібно у 4 рази менше високосмугової пам’яті (HBM) та у 8 разів менше місця на SSD-накопичувачах для зберігання KV-кешу порівняно з минулим поколінням.
Стиснення кешу дозволяє суттєво зменшити витрати на роботу ШІ-агентів, оскільки зчитування кешу становить значну частку загальної вартості запитів.
Зміни в API та виведення з експлуатації старих моделей
DeepSeek-V4.1-Flash вже доступна через офіційний API. У зв’язку з релізом компанія виводить з експлуатації застарілі моделі:
запити до V4-Flash та V4-Flash-Vision-Exp автоматично перенаправляються на V4.1-Flash;
модель V4-Pro також поступово згортається через повну перевагу V4.1-Flash за швидкістю, ціною та якістю. З 14 вересня (04:00 UTC) усі запити до V4-Pro перенаправлятимуться на V4.1-Flash за тарифами нової моделі — аж до релізу майбутньої V4.1-Pro.
Підтримку V4.1-Flash вже інтегрували офіційні партнери компанії — WorkBuddy_AI та OpenCode, що дозволяє використовувати модель для вайб-кодингу одразу після релізу. Оскільки модель поширюється з відкритим вихідним кодом, найближчим часом очікується її інтеграція багатьма іншими розробниками галузі.
«Чи є у мене талант, якщо комп’ютер може імітувати мене?». Штучний інтелект пише книги авторам Amazon Kindle. The Verge поспілкувався з авторами та виявив багато цікавого
Письменники-романісти використовують штучний інтелект для створення своїх творів. Видання про технології The Verge поспілкувалося з письменницею Дженніфер Лепп, яка випускає нову книгу кожні дев’ять тижнів, й дізналося про те, як працює штучний інтелект для написання романів. Наводимо адаптований переклад статті.
Хочете повідомити важливу новину? Пишіть у Telegram-бот
Головні події та корисні посилання в нашому Telegram-каналі