Українська відповідь на Jev. Codebridge за 20 днів зробила API, що ухвалює рішення за текстом українською, російською та суржиком
Українська Codebridge запустила Shvydko: API, яке за текстом обирає варіант, ставить оцінку й називає ймовірність


Українська Codebridge запустила Shvydko: API, яке за текстом обирає варіант, ставить оцінку й називає ймовірність
Українська Codebridge запустила Shvydko: API, яке за текстом обирає варіант, ставить оцінку й називає ймовірність
Українська команда Codebridge відкрила публічний API Shvydko: модель, яка не генерує текст, а ухвалює рішення. Вона обирає варіант зі списку, ставить оцінку за вашою шкалою або каже, наскільки ймовірно, що твердження правдиве. Відповідь повертається як JSON. Продукт працює у режимі безоплатного preview, є Playground для власних прикладів.
Codebridge з 2021 року розробляє софт і AI-системи для клієнтів. Засновники познайомилися в KPMG: Костянтин Карпушин (CEO) понад десять років працював там і дійшов до партнера, очолював напрям інновацій і технологій. Мирослав Будзанівський (CTO) понад 12 років працює архітектором ПЗ, раніше був у GlobalLogic, KPMG і Cybercube. Крім Shvydko, компанія робить голосове введення Lispr.
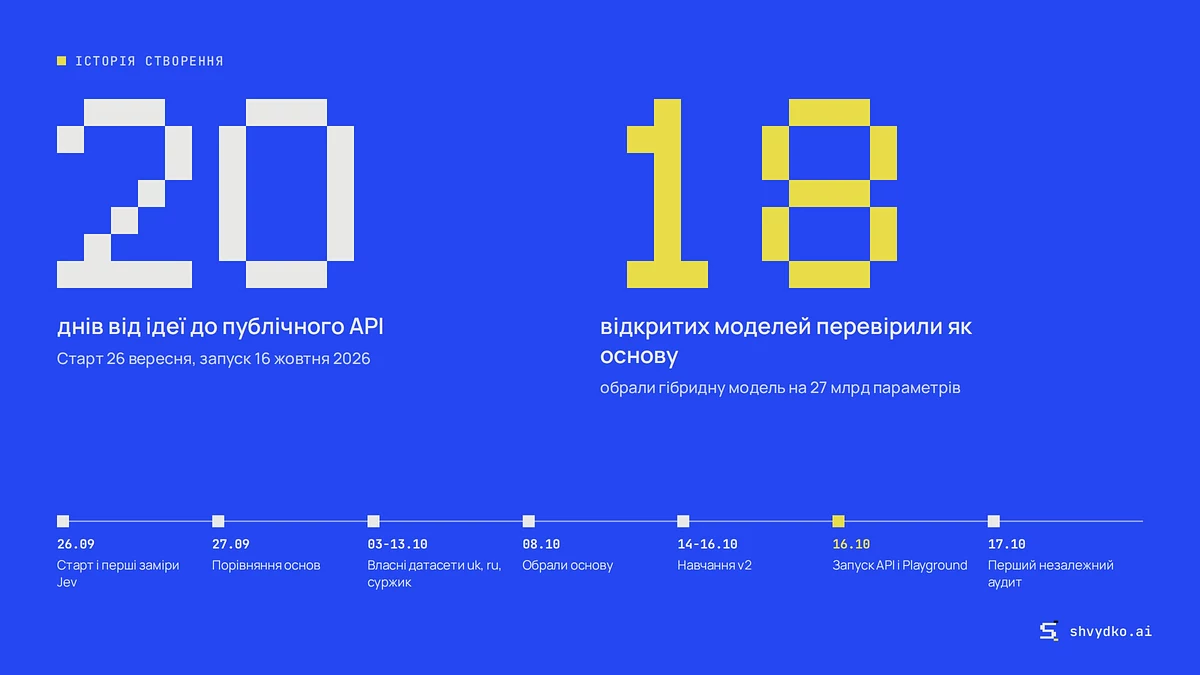
15 вересня американська TypeSafe відкрила доступ до Jev, моделі, яка не пише текст, а видає «каліброване рішення». За 24 дні компанія залучила близько $870 млн за оцінки $7,5 млрд, повідомляв Bloomberg. У Codebridge кажуть, що прогнали Jev на власних перших тестах і побачили розрив: англійською він відповідав правильно у 91% випадків, українською та російською в 81%. Клієнти ж пишуть українською, російською та суржиком, часто в одному повідомленні. 26 вересня команда почала робити власну модель, а 16 жовтня відкрила публічний API.
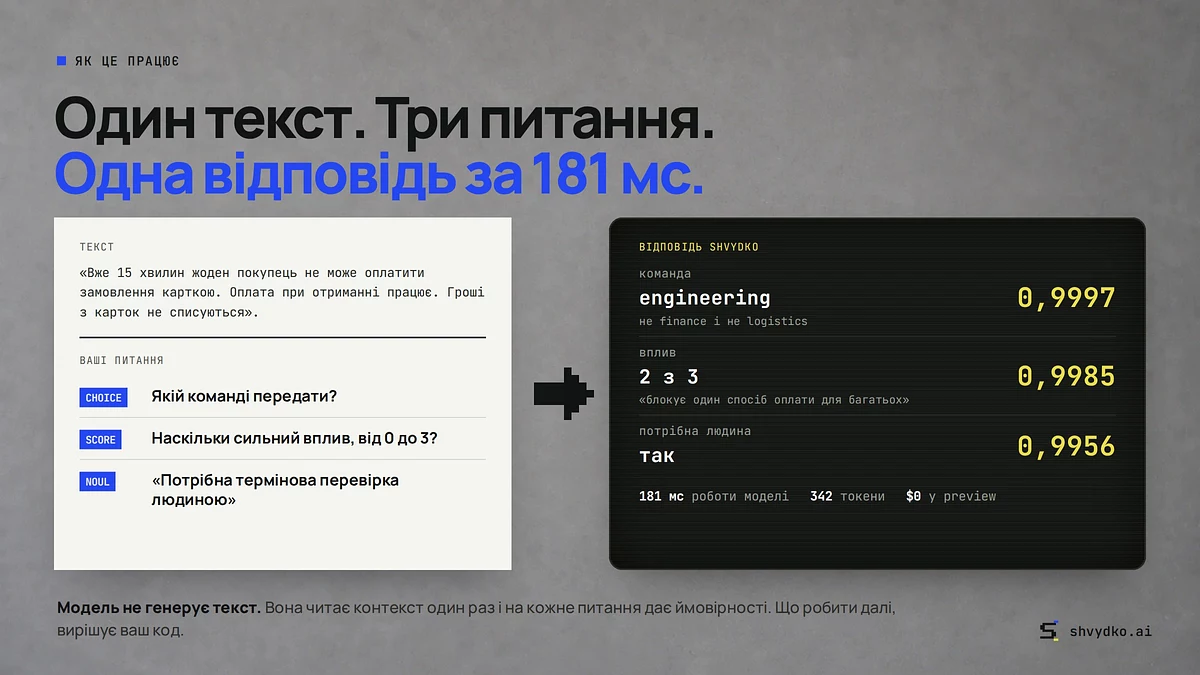
Розробник надсилає текст (звернення, лист чи документ до 32 тисяч токенів) і кілька питань трьох типів:
Модель читає текст один раз і відповідає на всі питання паралельно, кожне питання не бачить інших. У прикладі на сайті запит із трьома питаннями про збій оплати зайняв 181 мс роботи моделі. Це один синтетичний сценарій, а не тест якості.
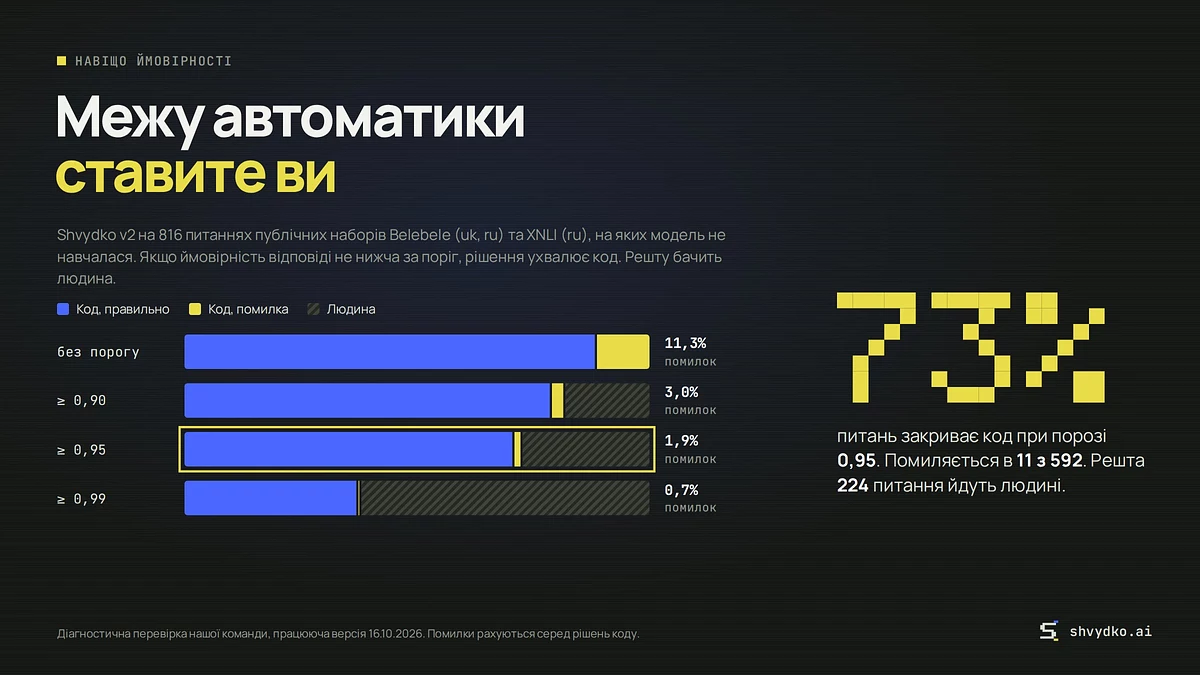
Головне у відповіді, за словами команди, ймовірність. Розробник сам ставить поріг: якщо впевненість моделі 95% і вище, код діє автоматично, якщо ні, рішення переглядає людина. На 816 питаннях із публічних наборів, яких модель не бачила під час навчання, такий поріг, за даними Codebridge, дав 73% автоматичних рішень і 1,9% помилок серед них. Формат запитів збігається з Jev, тож код під нього, як стверджує команда, переходить на Shvydko заміною адреси та ключа.
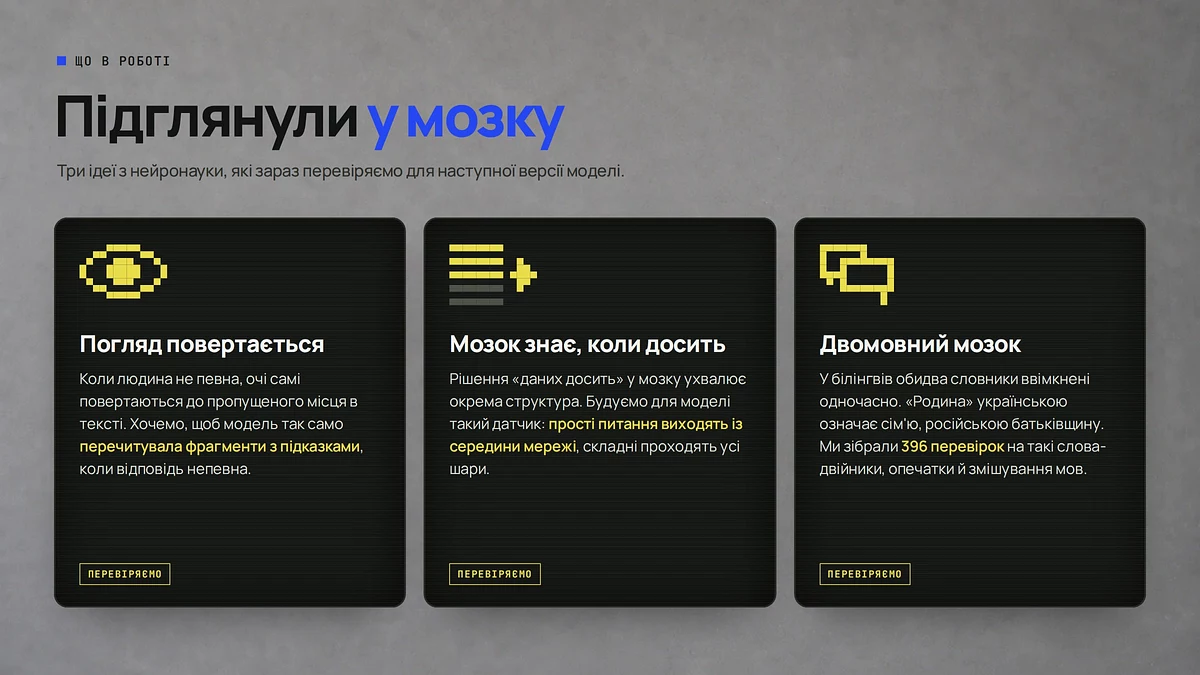
За словами CTO Мирослава Будзанівського, у основі відкрита модель Qwen на 27 млрд параметрів, донавчена за допомогою LoRA-адаптерів. Замість генерації тексту модель має «голову рішень», що одразу видає ймовірності варіантів. Команда також калібрує їх на відкладених даних, щоб на них можна було ставити поріг. Датасети зібрані українською, російською та суржиком: реальні тексти, синтетика від моделей-вчителів і розмітка кількома незалежними моделями-суддями. Навчали на GPU H200, обслуговують на GPU в ЄС. Над продуктом працює кілька людей, оренда обладнання коштує близько $800 на місяць.
Тариф: $0,042 за мільйон вхідних токенів, вихідні не оплачуються. Приблизно стільки ж, за даними видань, коштує й Jev. Для 100 тисяч запитів на місяць по ~800 токенів це близько $3,40. Заробляти команда планує не на токенах, а на окремих розгортаннях в ЄС або на сервері клієнта, дотренуванні на даних компанії та інтеграціях.
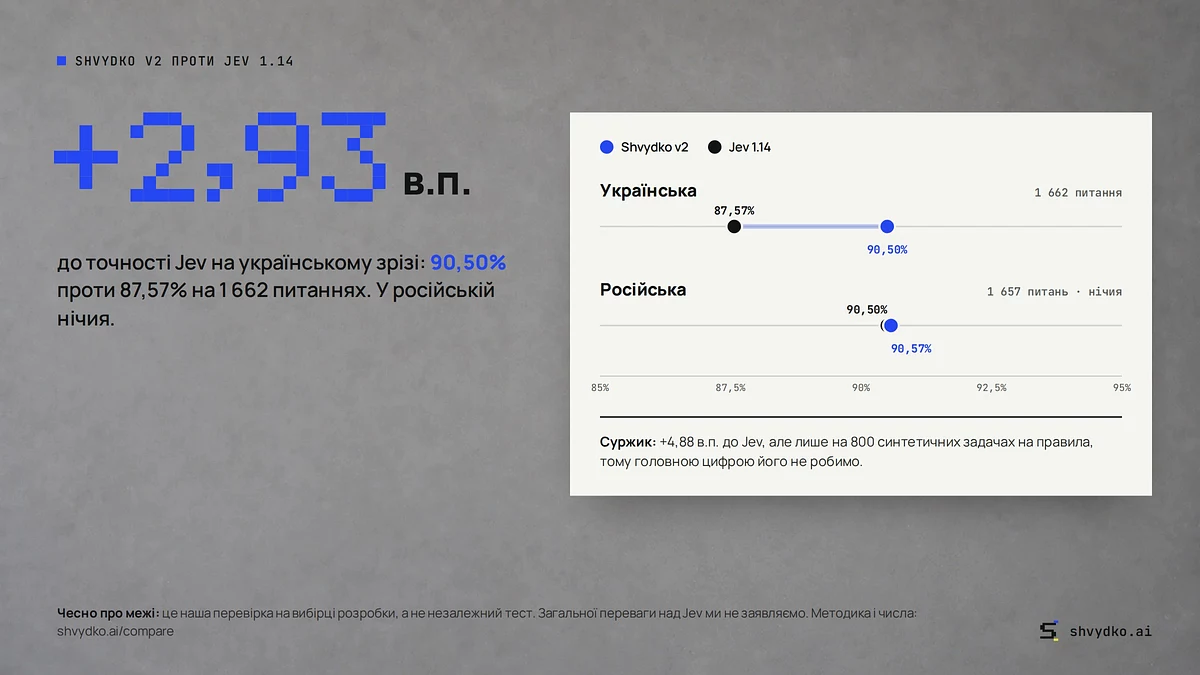
Codebridge самостійно порівняла Shvydko v2 з Jev 1.14 на своїй діагностичній вибірці. Українською це 90,50% проти 87,57% (+2,93 в. п., інтервал +0,77…+5,10), російською майже порівну (90,57% проти 90,50%, інтервал перетинає нуль). У суржику 100% проти 95,13%, але там лише синтетичні задачі на правила, тому це не оцінка знання мови. В українських задачах на висновок за уривком Jev навіть попереду: 94,66% проти 93,89%.
Сама компанія наголошує, що результат не доводить загальної переваги: це частина dev-панелі, не незалежний фінальний тест. Типи сценаріїв і генератор задач на правила збігаються з навчальними даними, а швидкість, економіку й англомовну якість не оцінювали.
Продукт щойно відкрився: поки це перші два десятки реєстрацій і кілька команд, що вже працюють з API. Один із перших користувачів надіслав два докладні звіти з власним порівнянням із Jev, його знахідки ввійдуть у наступну версію. Версію 3 обіцяють орієнтовно наприкінці листопада: точніша перевірка тверджень, довгі документи до 32 тисяч токенів і швидша модель. Також команда готує власний тест LIVE-UK на текстах із семи українських джерел, опублікованих після 1 червня 2026 року, і платний режим із першими командами на окремих розгортаннях.