Хочете будувати кар’єру в Data Science та AI? Vodafone Big Data Lab відкриває новий набір —>
Наталя ХандусенкоШІ
21 жовтня 2026, 13:26
2026-10-21
Українська компанія Zibra AI запустила ZibraXYZ: технологія для Physics AI, що стискає дані у 30 разів без потреби у розпакуванні
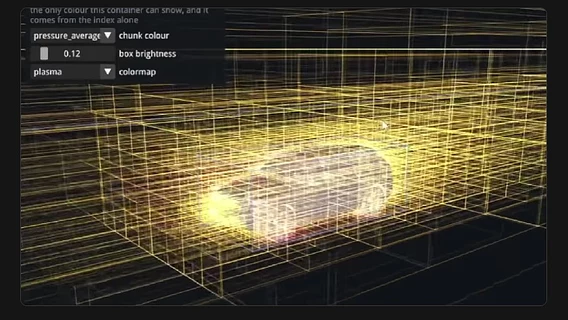
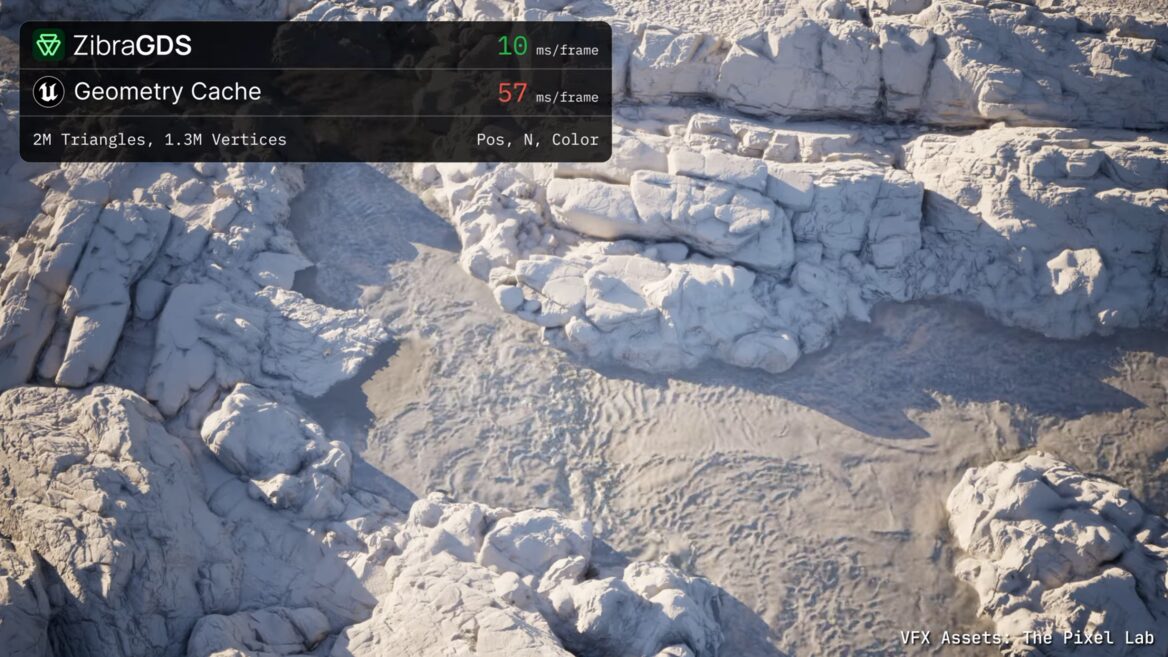
Український технологічний стартап Zibra AI анонсував ZibraXYZ — високопродуктивний шар даних для великих інженерних датасетів. Нова технологія дозволяє стискати інженерні 3D- та 4D-дані до 30 разів і працювати з ними напряму, навіть якщо їхній обсяг перевищує пам’ять робочої станції або відеокарти.
Український технологічний стартап Zibra AI анонсував ZibraXYZ — високопродуктивний шар даних для великих інженерних датасетів. Нова технологія дозволяє стискати інженерні 3D- та 4D-дані до 30 разів і працювати з ними напряму, навіть якщо їхній обсяг перевищує пам’ять робочої станції або відеокарти.
У чому полягає проблема галузі
Сфера Physics AI (штучний інтелект у фізичних системах, де моделі навчаються описувати поведінку реального світу) вимагає гігантських обсягів даних симуляцій та датчиків. Набори таких даних можуть бути в 1 000 — 10 000 разів більшими, ніж традиційні медіафайли.
Традиційні робочі процеси змушують компанії зберігати петабайти нестисненої інформації, годинами передавати її повільними мережами та створювати численні дублікати перед аналізом чи навчанням ШІ. Це робить зберігання та передачу даних вкрай дорогою, а підготовку й візуалізацію — повільною.
Як працює рішення ZibraXYZ?
ZibraXYZ пропонує фундаментально інший підхід. Дані організовуються в автономні стиснені блоки (сторінки) з можливістю довільного доступу.
Програма завантажує зі сховища лише ті поля, регіони, часові кроки чи роздільну здатність, які потрібні для конкретного завдання.
Декомпресія на GPU зі швидкістю до 500 ГБ/с: розпакування відбувається безпосередньо у пам’яті відеокарти (GPU), оминаючи процесор (CPU) та буфери проміжного зберігання.
Високий рівень стиснення: до 30x для структурованих сіток та до 15x для неструктурованих. Дані можна зберігати як без втрат, так і з контрольованою межею погрешності.
Універсальність підтримуваних форматів: підтримуються об'ємні сітки, поверхневі сітки, хмари точок та сплайни у 3D і 4D.
Завдяки цьому візуалізація починається одразу після надходження перших потрібних даних, а навантаження на мережу та пам’ять суттєво зменшується.
Сфери застосування та інтеграція
Стиснені дані залишаються повністю робочими у трьох ключових напрямках. Для візуалізації реалізовано інтерактивне дослідження часових кроків, зрізів і сіток із прогресивним завантаженням та прямою підтримкою ParaView за стандартом VTK.
У контексті навчання ШІ доступні вибіркове зчитування, буферизація, інтеграція з PyTorch і готові сценарії для відтворюваного вибору датасетів.
Крім того, для інженерного аналізу передбачено C++/Python SDK, що дозволяє створювати власні додатки та пайплайни.
Бажаючі випробувати ZibraXYZ на власних датасетах можуть замовити технічне демо на офіційному сайті zibra.ai/zibraxyz.
«Чи є у мене талант, якщо комп’ютер може імітувати мене?». Штучний інтелект пише книги авторам Amazon Kindle. The Verge поспілкувався з авторами та виявив багато цікавого
Письменники-романісти використовують штучний інтелект для створення своїх творів. Видання про технології The Verge поспілкувалося з письменницею Дженніфер Лепп, яка випускає нову книгу кожні дев’ять тижнів, й дізналося про те, як працює штучний інтелект для написання романів. Наводимо адаптований переклад статті.
Хочете повідомити важливу новину? Пишіть у Telegram-бот
Головні події та корисні посилання в нашому Telegram-каналі